Am 18. Mai 2026 war die Klimawerkstatt richtig gut gefüllt: 22 Menschen kamen zum KI Klub Werder, um mit Jörn über eine Frage zu sprechen, die gerade viele beschäftigt: Wie kommen KI-Agenten aus dem Proof of Concept in einen verlässlichen produktiven Einsatz?
Besonders schön war die Mischung im Raum. Es waren viele bekannte Gesichter dabei, aber auch einige neue Teilnehmende, die zum ersten Mal beim KI Klub waren. Dadurch wurde der Abend nicht nur fachlich dicht, sondern auch lebendig: Vortrag, Rückfragen, Beispiele aus der Praxis und danach viele Gespräche beim Networking.
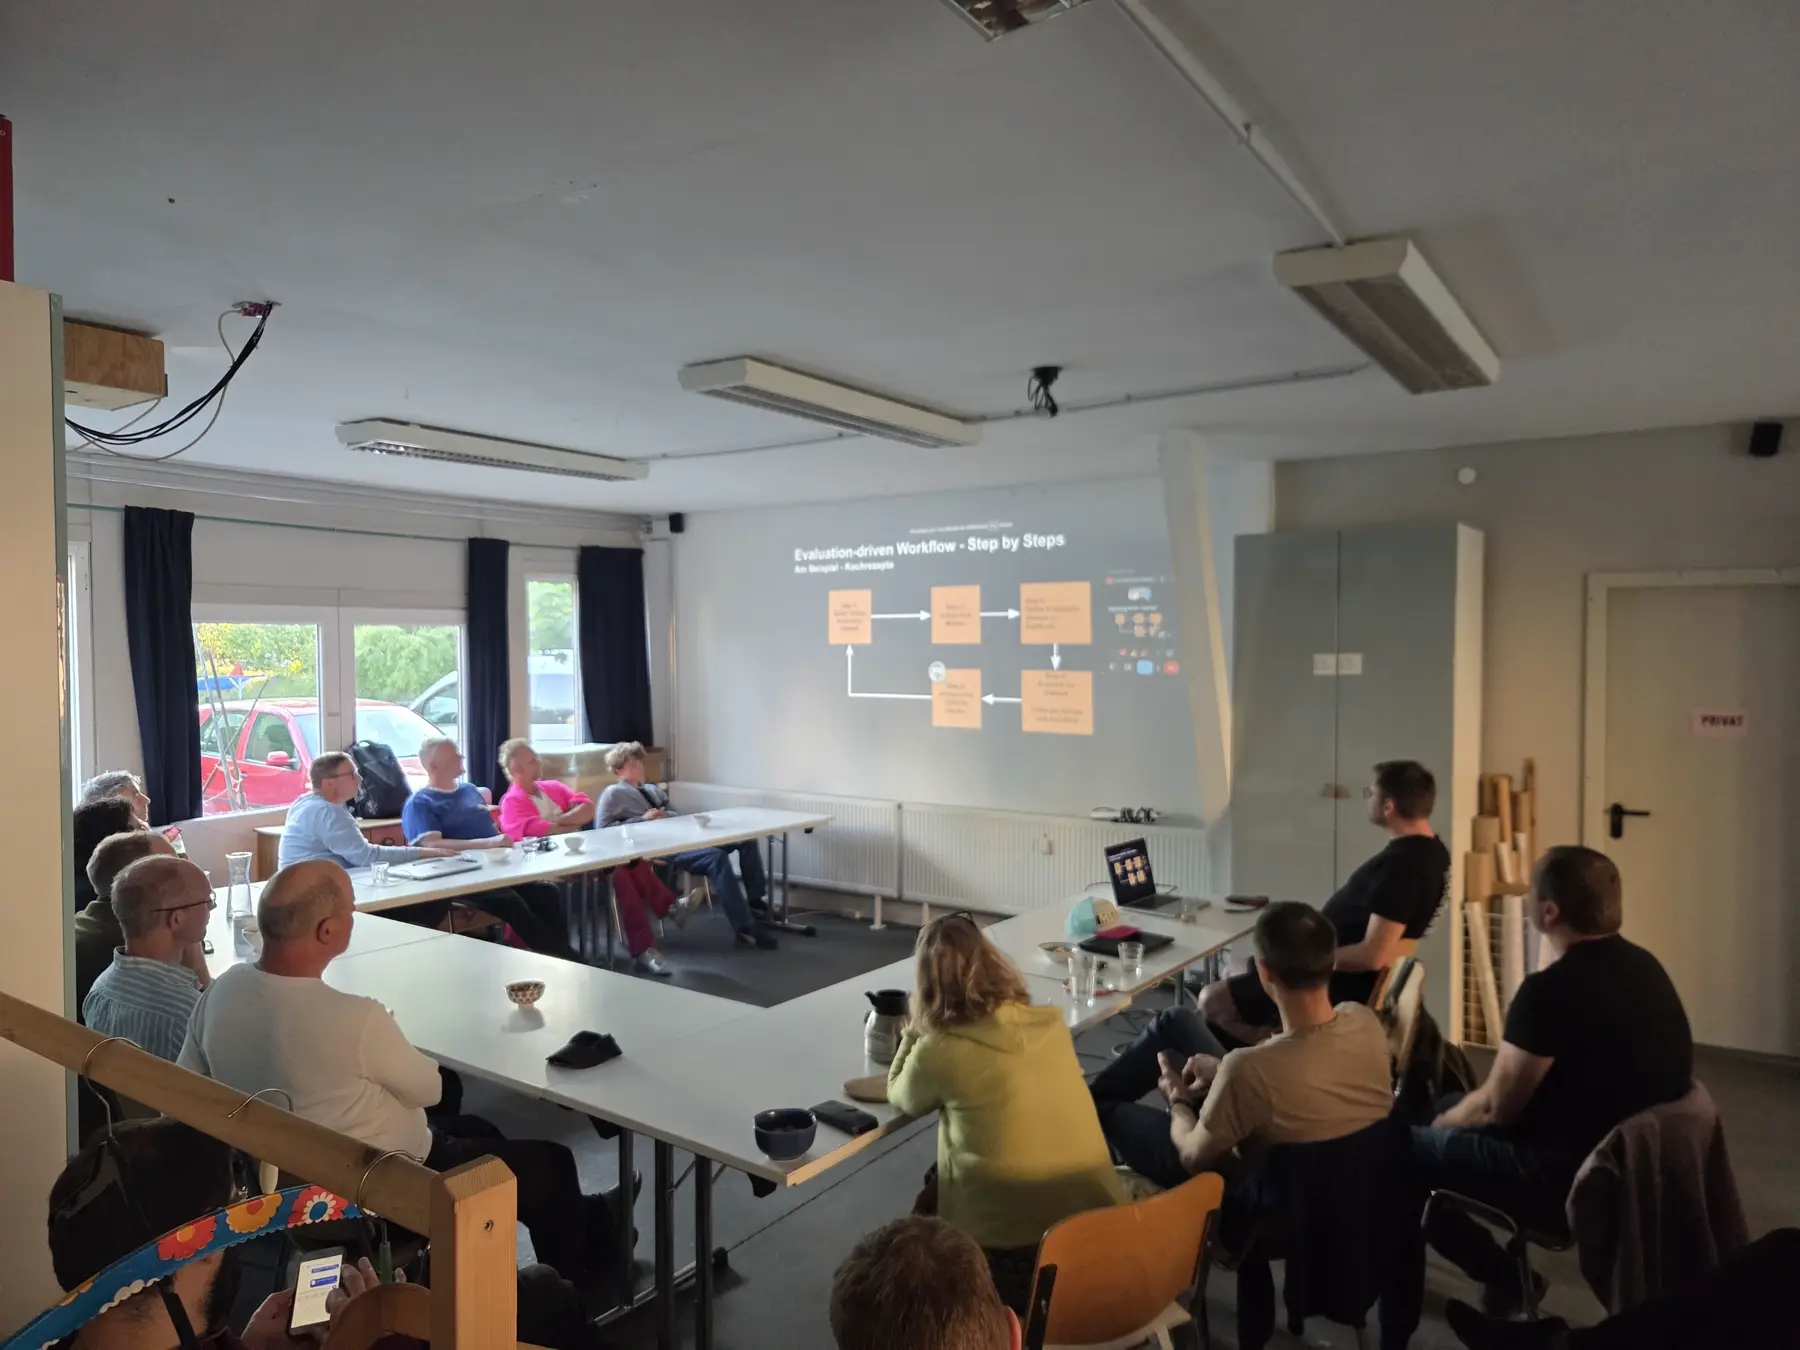 Volles Haus in der Klimawerkstatt: 22 Teilnehmende, eine gute Mischung aus neuen und regelmäßigen Gästen.
Die Leitfrage des Abends
Viele KI-Agenten wirken in Demos beeindruckend. Sie beantworten Fragen, nutzen Tools, recherchieren, planen Zwischenschritte und liefern Ergebnisse, die auf den ersten Blick sehr produktionsnah aussehen. Aber genau dort beginnt das eigentliche Problem: Im Alltag reicht ein guter Demo-Moment nicht aus.
Jörns zentrale These war deshalb angenehm nüchtern: Der Weg in die Produktion führt nicht zuerst über noch bessere Prompts, sondern über bessere Messbarkeit. Wer KI-Agenten ernsthaft einsetzen will, muss sichtbar machen, wann sie richtig liegen, wann sie raten, wann sie Tools falsch nutzen, wo Kosten entstehen und welche Qualität tatsächlich beim Menschen ankommt.
 Jörn führte durch den Abend: von der Agenten-Architektur bis zur Frage, wie man Qualität überhaupt zuverlässig bewertet.
Agenten sind beweglicher als Workflows — und genau deshalb schwieriger
Ein klassischer Workflow folgt festen Regeln: Wenn A passiert, mache B. Agenten sind offener. Sie können Werkzeuge auswählen, Zwischenergebnisse bewerten und mehrstufig handeln. Diese Beweglichkeit ist ihre Stärke, aber auch der Grund, warum sie in produktiven Umgebungen neue Fehlerquellen erzeugen.
Im Vortrag ging es deshalb um typische Risiken:
- Nicht-Determinismus: derselbe Input kann leicht unterschiedliche Outputs erzeugen.
- Überkonfidenz: Antworten klingen sicher, obwohl sie es nicht sind.
- Tool-Fehler: ein Agent wählt das falsche Werkzeug oder interpretiert Ergebnisse falsch.
- Latenz und Kosten: mehrstufige Agenten können langsam und teuer werden.
- schwierige Qualitätsbewertung: eine Antwort kann richtig sein, obwohl sie anders formuliert ist als erwartet.
Der wichtigste Unterschied zur klassischen Software wurde dabei sehr klar: Bei KI-Systemen reicht Unit-Test-Denken allein nicht aus. Semantische Qualität muss mitbewertet werden.
 Der Kern des Abends: Agenten brauchen nicht nur gute Prompts, sondern einen nachvollziehbaren Evaluationsprozess.
Evaluation-Driven Development für KI-Agenten
Der praktische Teil drehte sich um einen Workflow, der KI-Systeme Schritt für Schritt robuster macht:
Evaluationsdatensatz bauen
Echte Fragen, echte erwartete Antworten und relevante Metadaten sammeln. Nicht nur intern ausgedachte Idealbeispiele, sondern möglichst nah am späteren Einsatz.Metriken pro Use Case definieren
Je nach Anwendung können andere Kriterien zählen: Factual Correctness, Gesprächsqualität, Tool Correctness, Information Recall, URL-Validität, Kosten, Latenz oder Pass-at-K.Evaluatoren kombinieren
Deterministische Checks dort nutzen, wo sie passen. Für semantische Bewertung können LLM-Judges helfen. Für Syntax, Regeln und Logik sind Code-Checks oft besser.Runs vergleichen und nachjustieren
Nach jeder Änderung prüfen: Hat sich der Agent wirklich verbessert, oder sieht es nur wegen Rauschen so aus?
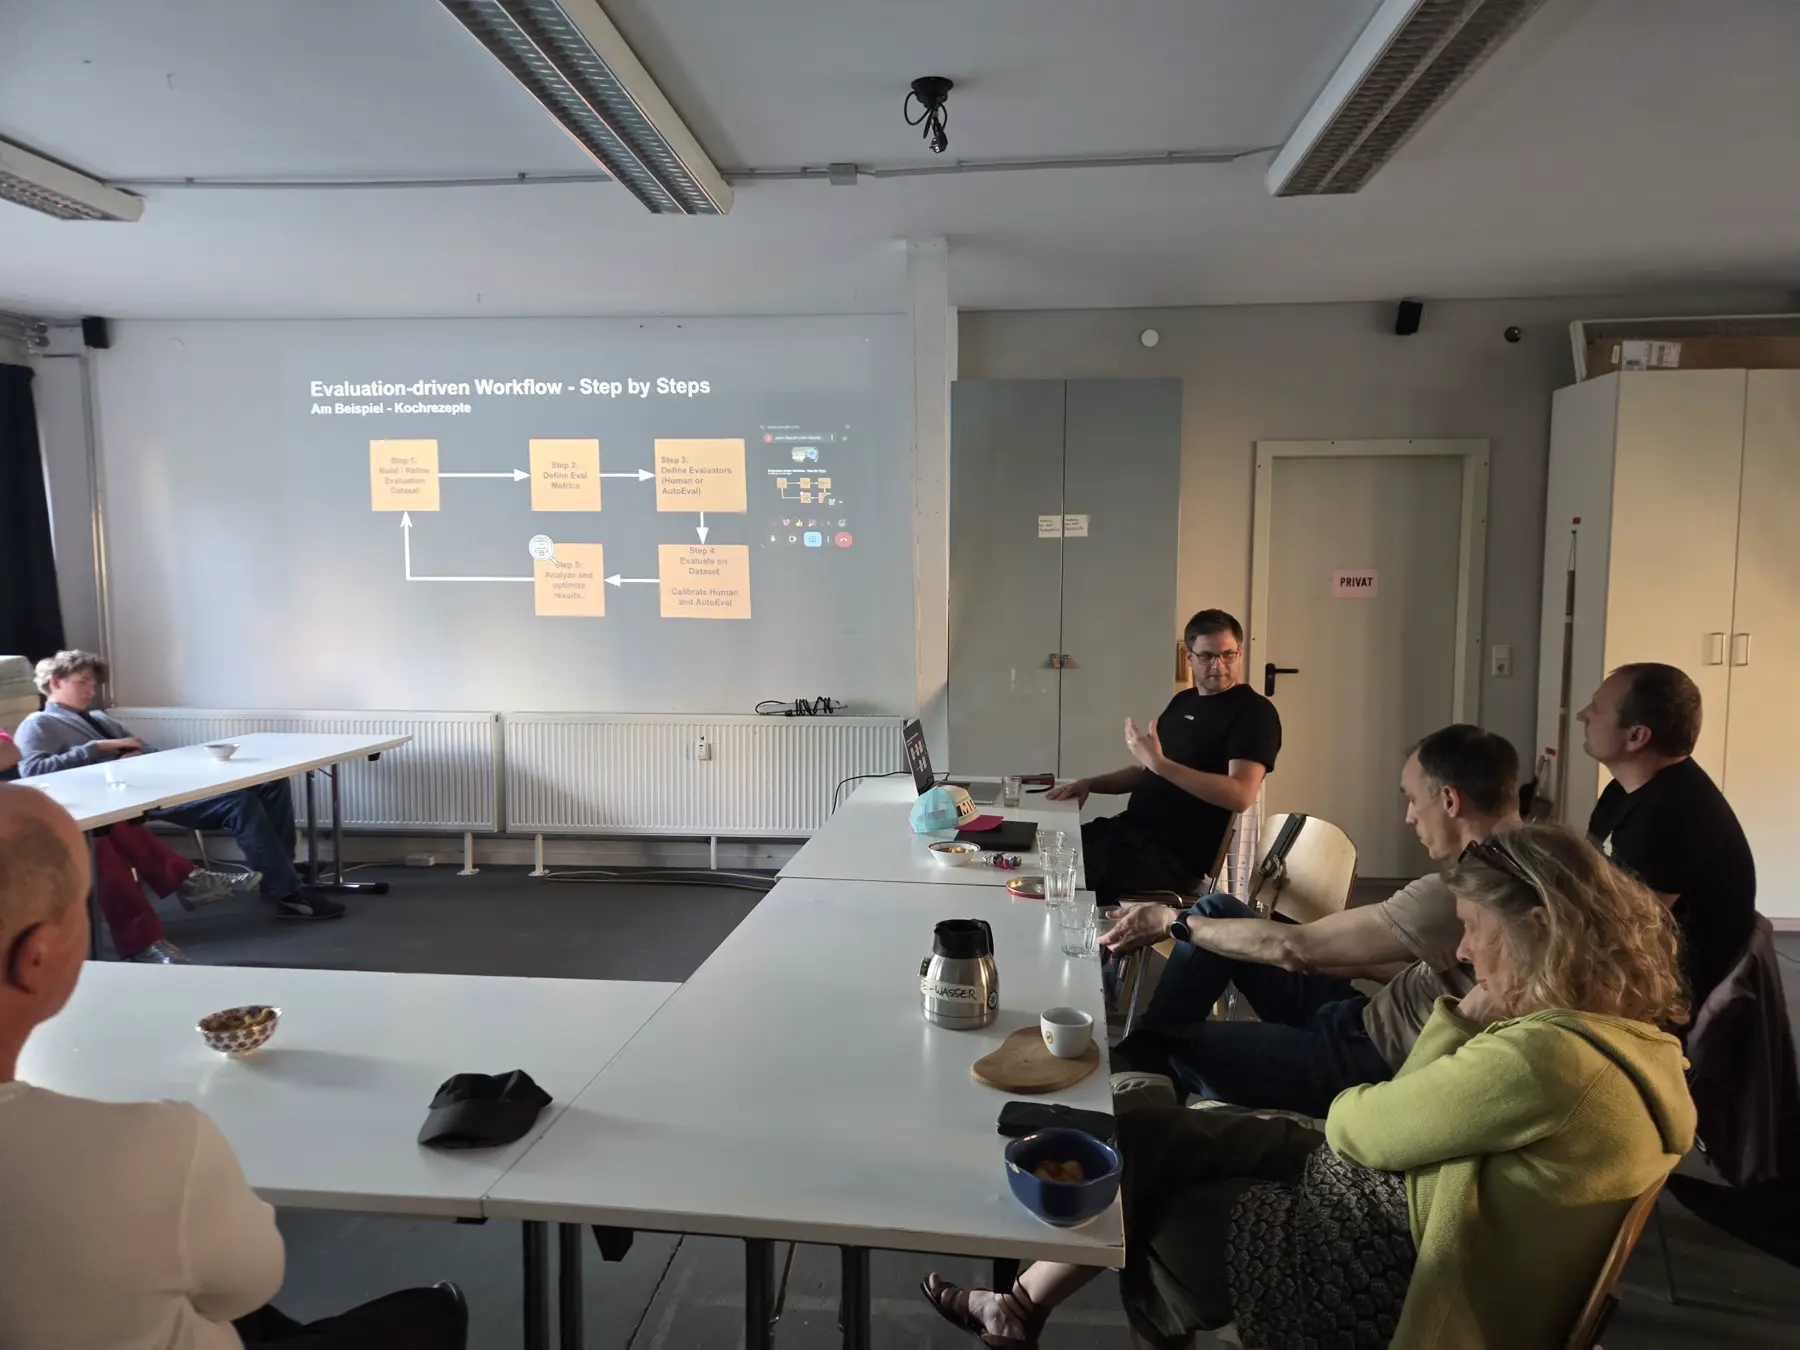 Evaluation-Driven Development als Handwerk: Datensatz, Metriken, Evaluatoren, Vergleichbarkeit.
Beispiel aus dem Raum: E-Mail-Agent für einen Reiterhof
Sehr greifbar wurde das Thema an einem Beispiel aus der Diskussion: Ein Bauernhof mit Reiterhof erhält viele wiederkehrende E-Mail-Anfragen. Ein KI-Agent könnte hier Entwürfe vorbereiten, basierend auf einer Wissensbasis, echten Anfragen und echten Antworten.
Wichtig ist dabei nicht, sofort voll zu automatisieren. Der sinnvolle erste Schritt wäre: Die KI schreibt Antwortentwürfe, die Landwirtin korrigiert und sendet. Danach werden KI-Entwurf und tatsächliche Antwort verglichen. So entsteht ein wachsender Evaluationsdatensatz — und damit eine Grundlage, um später verantwortungsvoll zu entscheiden, ob einzelne Antworten automatisch verschickt werden können.
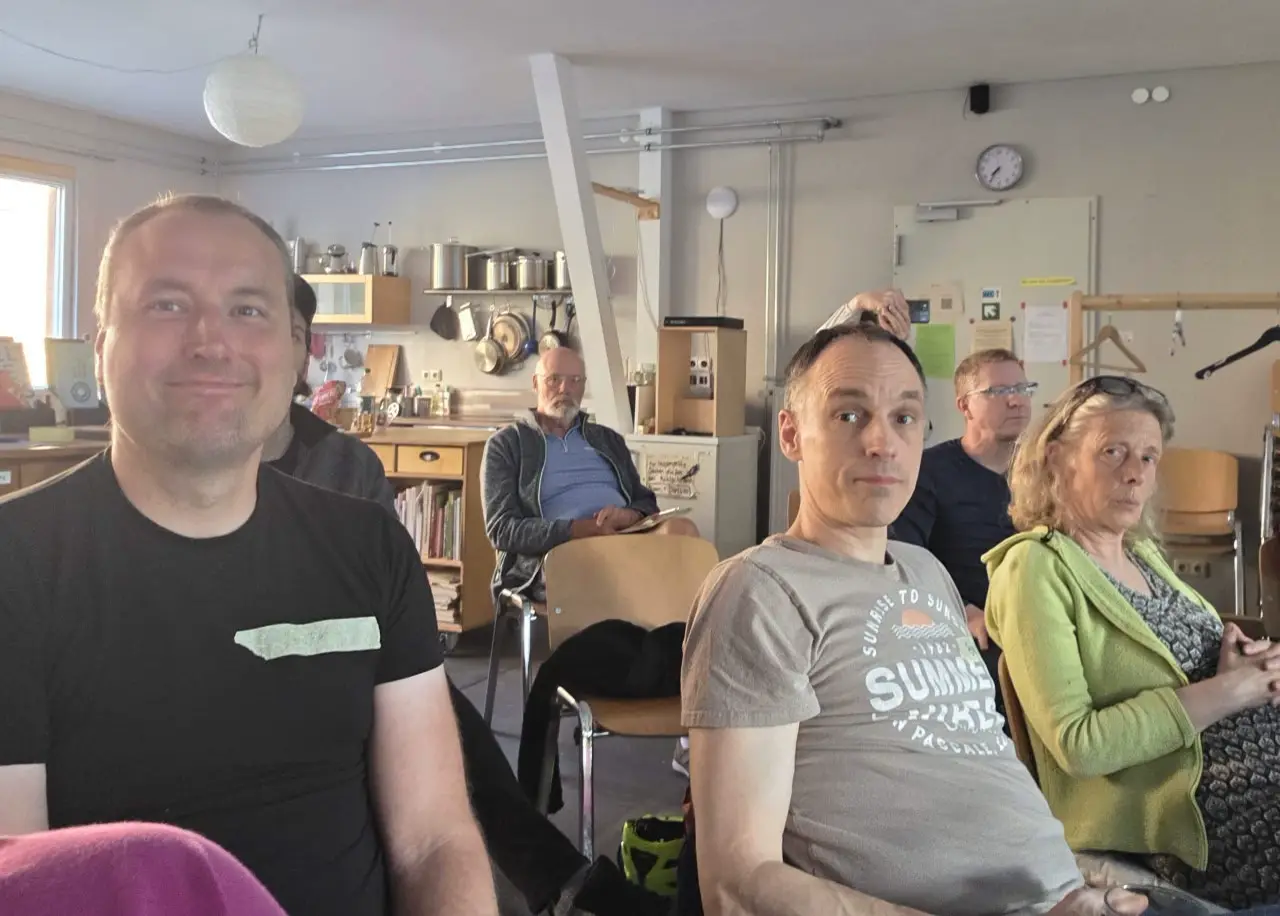 Viele Fragen aus dem Raum machten den Abend besonders praxisnah: Was muss ein Agent leisten, damit man ihm wirklich vertrauen kann?
Was für Produktion wirklich wichtig ist
Mehrere Begriffe zogen sich durch den Abend: Tracing, Observability, Human Feedback und Re-Kalibrierung. Tools wie Langfuse oder Phoenix helfen dabei, Agenten lesbar zu machen. Sie zeigen nicht nur die finale Antwort, sondern auch Prompts, Tool-Aufrufe, Zwischenergebnisse, Fehler und Scores.
Das ist entscheidend, weil man KI-Agenten sonst nur von außen bewertet. Wer aber nicht sieht, warum ein Agent etwas getan hat, kann ihn schwer verbessern.
Gleichzeitig blieb eine klare Grenze: LLM-as-a-Judge ersetzt keine menschliche Verantwortung. KI kann beim Skalieren von Bewertungen helfen. Aber fachliche, ethische und organisatorische Entscheidungen müssen weiterhin Menschen treffen.
Danach: Networking, Gespräche, neue Kontakte
Nach dem Vortrag ging es direkt weiter in den offenen Austausch. Genau das macht die Abende im KI Klub aus: Manche kommen mit konkreten Projekten, andere mit ersten Fragen, wieder andere mit Erfahrung aus Unternehmen, Verwaltung, Bildung oder Selbstständigkeit. Aus dieser Mischung entstehen die besten Gespräche.
 Nach dem Vortrag blieb noch viel Zeit für Austausch in kleineren Gruppen.
 Vom Vortrag ins Gespräch: neue Kontakte, offene Fragen und konkrete Ideen für die nächsten KI-Experimente.
Der Takeaway
Wer KI-Agenten ernsthaft einsetzen will, braucht ein kleines Testlabor: echte Fälle, klare Qualitätskriterien, Traces, menschliches Feedback und regelmäßige Re-Kalibrierung.
Der Schritt von PoC zu Produktion ist weniger Magie als Handwerk. Und genau das war vielleicht die wichtigste Botschaft des Abends: KI-Agenten werden nicht dadurch zuverlässig, dass man ihnen vertraut. Sie werden zuverlässig, wenn man sie beobachtet, misst, korrigiert und aus echten Fällen lernen lässt.